Aller au contenu
Hyperfluid 2.0 est disponible console.hyperfluid.cloud/signup
Construction de base documentaire

Vos PDF, vos emails et vos fichiers deviennent une base interrogeable.

Des pipelines d'OCR, de classification et de résumés, dans votre périmètre

Assemblez un pipeline dans la console : un déclencheur, une source, des étapes, une destination. Six modèles pré-câblés lisent vos PDF et vos pièces jointes, les classent, les résument et les rangent dans des tables Iceberg ou des dossiers. L'OCR et la classification tournent sur un modèle servi dans votre cluster, ou sur une API tierce si vous le préférez.
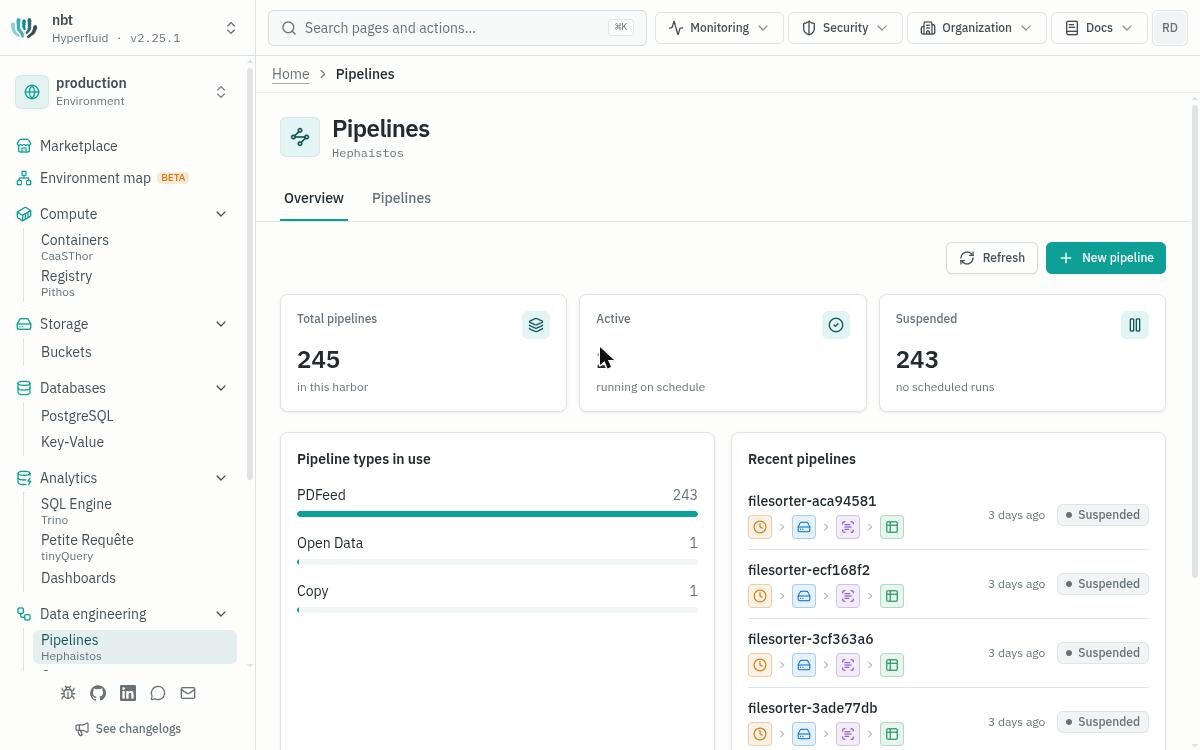
La console Hyperfluid, page Pipelines : les pipelines de documents, leurs types et leurs dernières exécutions

Spécifications

Éditeur de pipeline
Déclencheur, source, étapes, destination
OCR & extraction
PDF, Word, images vers tables Iceberg
Classification LLM
Labellisation et tri en dossiers
Hippocampe
Résumés L0/L1 cherchables par les agents
Modèles
Six pipelines pré-câblés, ou une page blanche
Pilotage
Planification cron, console et hfctl

Cas d'usage

Trier les documents entrants

Factures, devis, courriers : le pipeline Sort files lit chaque document, le labellise et le range dans le bon dossier

Tri automatique, dossier par dossier

Interroger vos PDF

Extract documents passe un bucket de PDF à l'OCR et pose le résultat dans une table Iceberg, interrogeable comme n'importe quelle table

Du PDF à la table Iceberg

Donner une mémoire à vos agents

Memory distillation résume une table en niveaux L0 et L1 (Hippocampe) : vos agents IA cherchent dans la synthèse avant de plonger dans le détail

Recherche progressive

En action

Classer le flux documentaire entrant

Une équipe de gestion immobilière reçoit chaque jour factures, devis et courriers par email

  1. Brancher le connecteur email sur la boîte de gestion
  2. Partir du modèle Sort files : désigner le bucket, le modèle de classification et les labels
  3. Déployer : à chaque échéance, le pipeline range chaque document dans le bon dossier, copropriété par copropriété
  4. Suivre les exécutions depuis la vue d'ensemble des pipelines

Plus de tri manuel : chaque document arrive classé au bon endroit

Rendre interrogeables des archives PDF

Une équipe data doit rendre exploitable un stock d'archives PDF accumulées depuis des années

  1. Déposer les archives dans un bucket S3 de l'organisation
  2. Partir du modèle Extract documents : bucket source, catalogue et schéma Iceberg de destination
  3. L'OCR tourne sur le modèle servi dans votre cluster, les données atterrissent dans une table Iceberg
  4. Interroger les archives en SQL depuis Petite Requête

Des années d'archives deviennent une base documentaire interrogeable

Avantages clés

  • Vos documents deviennent une base interrogeable, en SQL et par vos agents IA
  • Six pipelines pré-câblés, un éditeur visuel pour les adapter, un tableau de bord pour les suivre
  • Alimentés par vos connecteurs : email entrant, Google Drive, buckets S3
  • Tout s'exécute dans votre périmètre : OCR et classification sur un modèle servi dans votre cluster

Prêt à faire parler vos documents ?

Découvrez comment les pipelines de documents construisent votre base documentaire.