 Français
 English
 Français (Canada)
Analytics cross-source
Joindre votre PostgreSQL géré avec vos tables Iceberg dans une seule requête
Plusieurs sources, une seule requête SQL
Supprimez les silos organisationnels
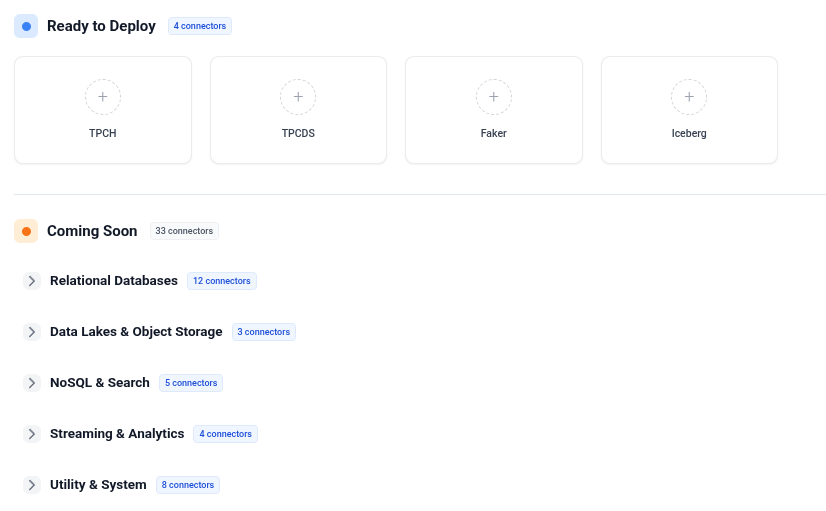
Réunissez vos sources de données dispersées derrière un moteur d'analyse unique. Construit sur Trino et Apache Iceberg, Data Hub fédère votre PostgreSQL géré et vos tables Iceberg posées sur le stockage objet S3 en une seule base requêtable, et s'alimente via les connecteurs de données ouvertes, Google Drive et Courriel.
Joindre votre PostgreSQL géré avec vos tables Iceberg dans une seule requête
Plusieurs sources, une seule requête SQL
Analytique avancée sur jeux de données distribués
Sans pipeline ETL à maintenir
Données ouvertes vers Iceberg, fichiers Google Drive et pièces jointes de courriel vers S3 : les connecteurs alimentent votre lakehouse requêtable
Sans code d'ingestion à écrire
Un analyste doit croiser les données clients stockées dans PostgreSQL avec les événements produit stockés en tables Iceberg
Un croisement multi-sources sans extraction préalable ni copie intermédiaire
Une équipe finance consolide son reporting mensuel à partir de sa base PostgreSQL et de ses tables Iceberg
Un reporting consolidé, interrogeable en SQL, sans pipeline à maintenir
Une équipe data alimente son lakehouse avec des jeux de données ouvertes et collecte ses fichiers métier depuis Google Drive et une boîte de courriel
Un lakehouse alimenté depuis la console, sans code d'ingestion à écrire
Moteur SQL distribué et sans état. Requêtez vos sources connectées avec du SQL standard, sans déplacer vos données.
Format de table open source pour les lacs de données : transactions ACID, évolution de schéma, compaction et expiration des instantanés pilotées depuis la console.
Données ouvertes, fichiers et courriels alimentent vos tables Iceberg et vos buckets S3 sans pipeline à écrire. D'autres sources de fédération arrivent bientôt.
Découvrez comment Data Hub peut éliminer vos silos de données.